Note 03実験小屋入り(駒場小空間)
役者の
- #画像認識
- #リアルタイム処理
- #人物再識別
- #オープンソース
- #低コスト
大規模な劇場では、役者の位置を検出して音響や照明を連動させる演出が広がりつつありますが、小規模な劇場ではそのための機材費が導入の壁になっています。
本実験では、オープンソースの画像認識モデルをそのまま用い、役者ごとの特徴を登録することで、舞台上の役者を検出するだけでなく識別し、その位置座標をリアルタイムで取得・送信するシステムを構築しました。
ここで得られた座標は、字幕の表示方式の比較実験で用いられました。この他にも、リアルタイムでの役者の座標取得は、音響や照明の追跡にも貢献することが期待されます。
本実験は試行として役者2名の簡易的な識別実験に留めましたが、数分の撮影データだけで高い識別精度が得られました。一方、学習時にない照明条件での誤認識や、処理速度による追従の遅れなどの課題も見えてきました。
はじめに
大規模な劇場では、役者の位置をリアルタイムに把握する「トラッキング」技術の導入が進みつつあります[1]。
役者の位置がわかれば、立体音響と組み合わせてマイクの声を役者のいる方向から鳴らしたり、照明を役者の動きやアドリブに合わせて追従させたりと、演出の幅が大きく広がります。
一方、既存の手法の多くは深度センサや役者に取り付ける赤外線マーカー・発信器など、専用の高価な機材を前提としており、小規模な劇場ではほとんど導入されていません。
そこで本実験では、手元にあるスマートフォンのカメラと、無料で公開されているオープンソースの画像認識モデルだけで役者のトラッキングを試み、どこまでの精度が出るのか、どこに限界があるのかを確かめました。
実験手法
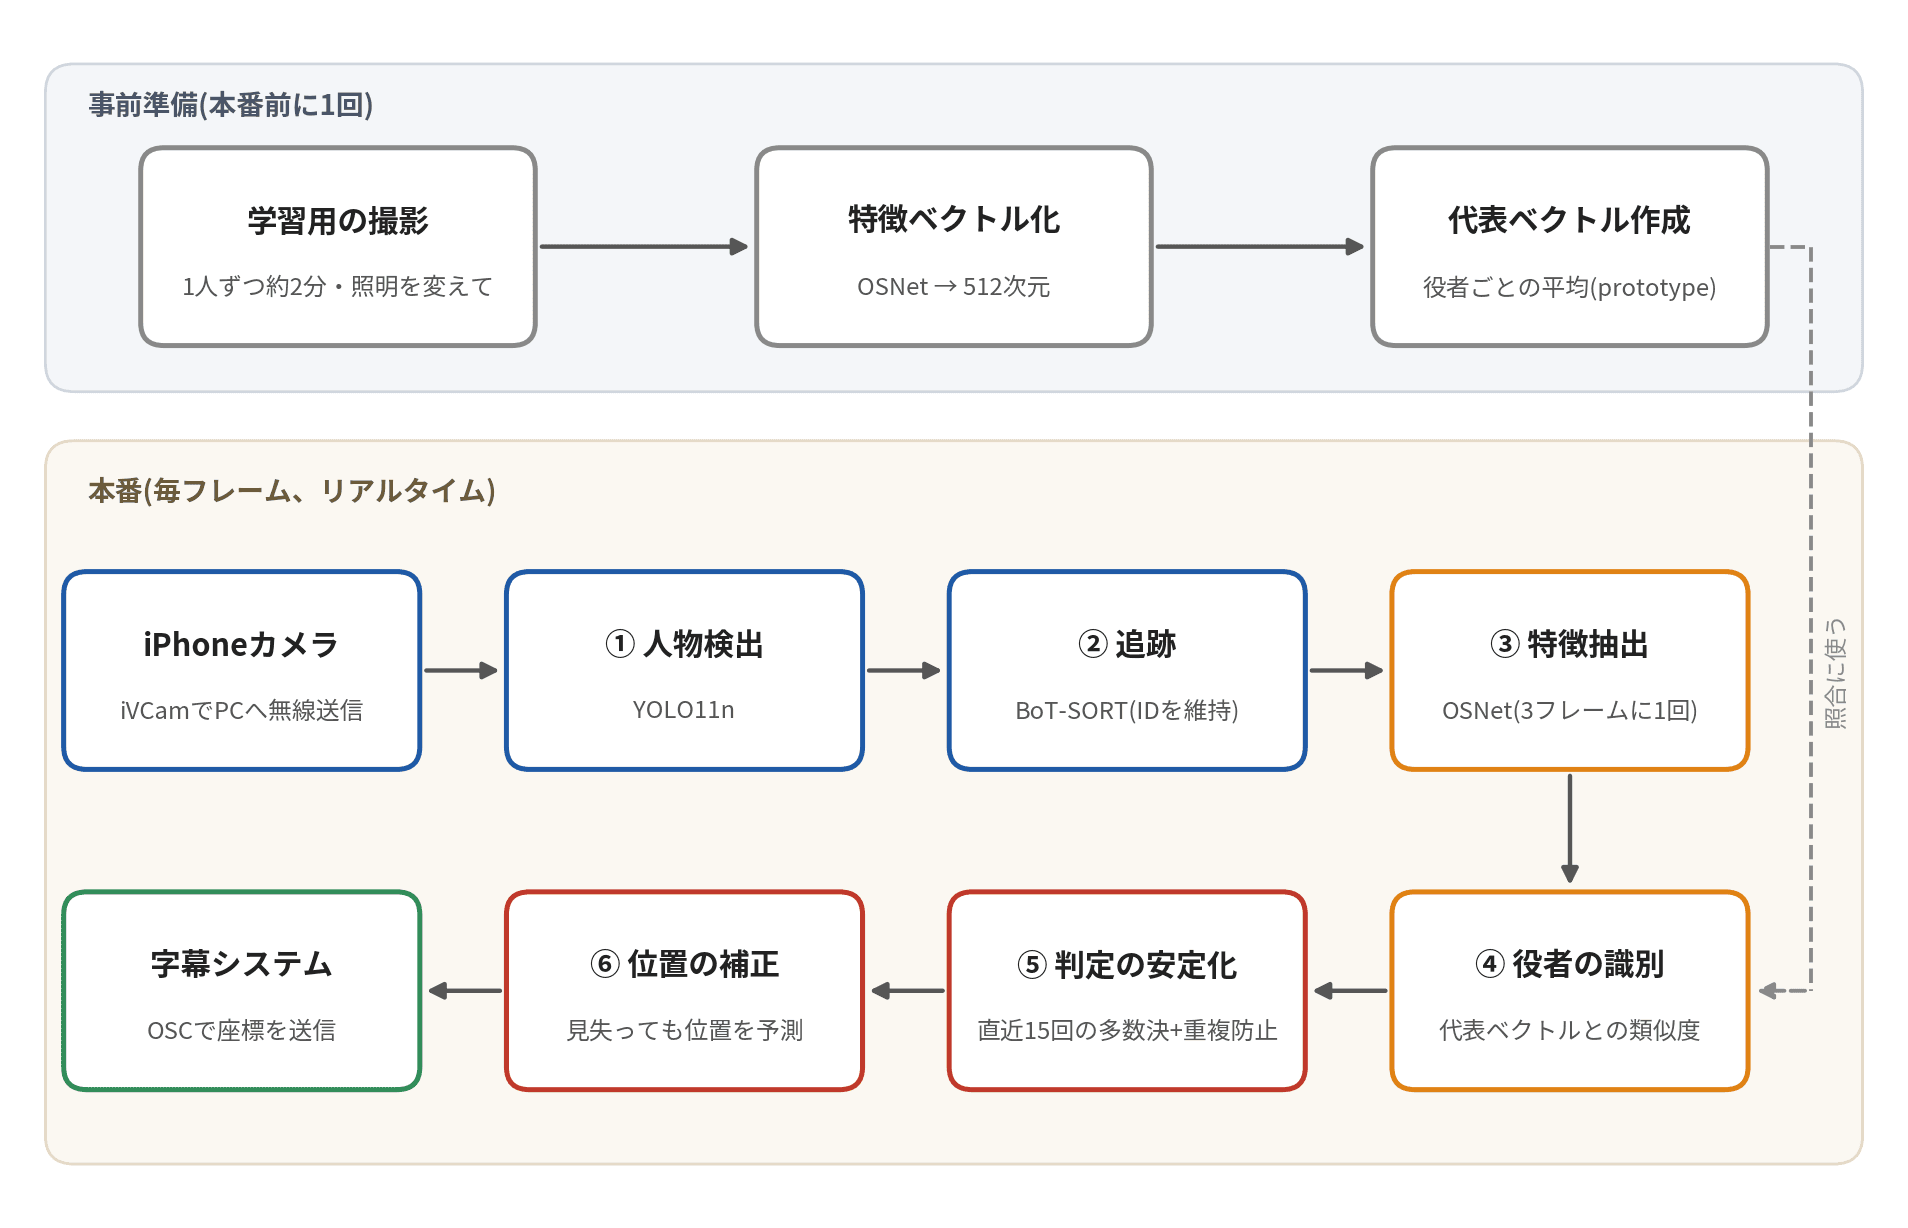
システムの全体像を図1に示しました。
大きく分けて、事前学習と推論の2つのステップから成ります。
事前学習では、各役者の画像から抽出した特徴ベクトルをもとに、役者ごとの代表ベクトルを登録しました。
推論では、この代表ベクトルと照合して、カメラ映像に写った人物を識別しました。
使用した技術スタックを表1に示します。モデルはいずれも無料で利用できるもので、利用した機材はスマートフォンとノートPCのみです。
表1使用した技術
| 機能 | 使用したもの | 内容 |
|---|---|---|
| カメラ | iPhone + iVCam | iPhoneの映像をPCへ無線で送信 |
| 人物検出 | YOLO11n(Ultralytics, Pythonライブラリ)[2] | 画像の中から人を検出し、枠(バウンディングボックス)で囲む |
| 追跡 | BoT-SORT(Ultralytics内蔵のアルゴリズム)[3] | 枠の動きを前後のフレームでつなぎ、同じ人物に同じ番号を振り続ける |
| 特徴抽出 | OSNet(Omni-Scale Network)[4] | 事前学習済みのCNNモデル。 軽量で高精度なRe-ID(人物再同定)タスクを行える |
| 識別 | 代表ベクトルとの照合 | 役者ごとに登録した特徴ベクトル |
| 送信 | OSC(UDP) | 判定した役者の座標(バウンディングボックスの下辺中央)を字幕システムへ送る |
事前学習
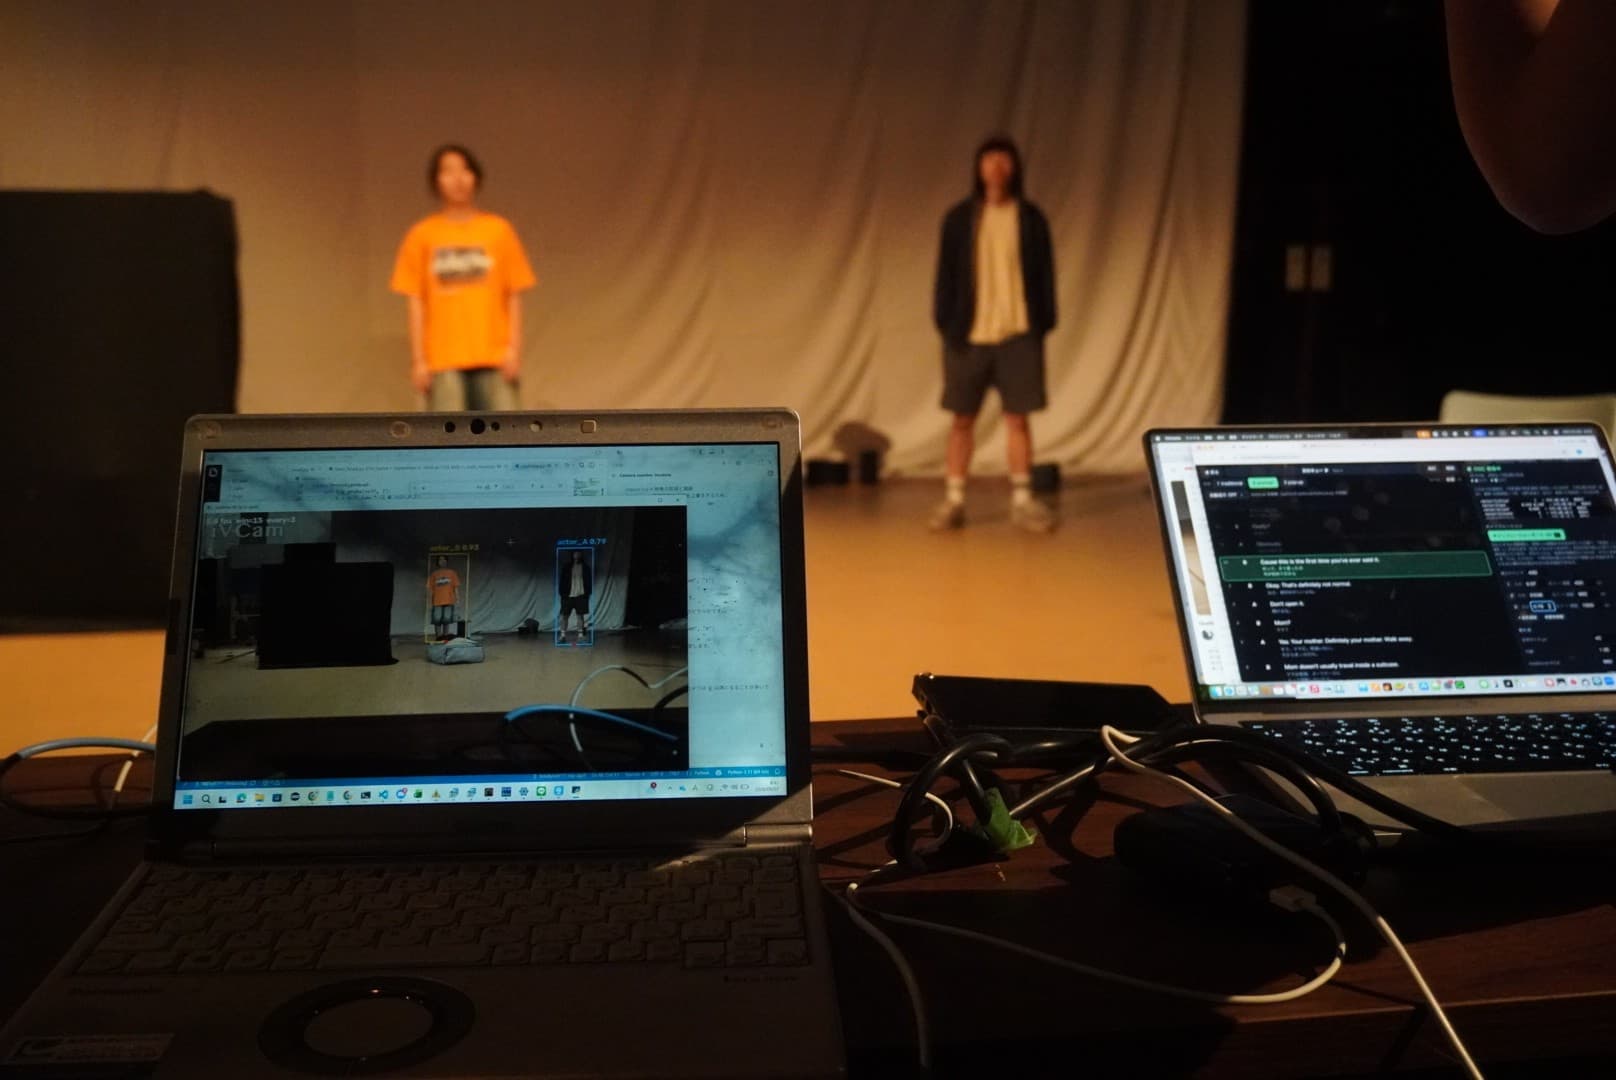
事前学習では、役者2人に対し、1人ずつカメラの前で数分間動いてもらい、検出された人物の画像を自動で切り出して保存しました。
1人あたり約150枚の学習用画像データを集めました。役者ごとに全ての画像に対して、特徴抽出モデルOSNetを適用して512次元の特徴ベクトル(L2正規化)を抽出し、これらの平均をその役者の代表ベクトルとして登録しました。
推論
本番の映像から切り出した画像を特徴ベクトルに変換し、各役者の代表ベクトルとの内積をとり、ソフトマックス関数の出力値を用いて判定しました。
工夫した点
リアルタイムで安定して動かすために、特に次の3点を工夫しました。
- 多数決による判定の安定化:1フレームだけの判定は向きや姿勢で揺らぐため、同じ人物について直近15フレーム分の判定をまとめて多数決をとりました。多数決による判定の安定化:1フレームだけの判定は向きや姿勢で揺らぐため、同じ人物について直近15フレーム分の判定をまとめて多数決をとりました。
- 重複の防止:「舞台上の同じ役者は同時に1人しかいない」という制約条件を入れ、2人を同じ役者と判定しないようにしました。重複の防止:「舞台上の同じ役者は同時に1人しかいない」という制約条件を入れ、2人を同じ役者と判定しないようにしました。
- 計算の間引き:計算負荷の高い特徴抽出の計算を3フレームに1回だけ行い、その間は追跡の番号を頼りに前回の判定を引き継ぐことで、処理の遅れを抑えました。計算の間引き:計算負荷の高い特徴抽出の計算を3フレームに1回だけ行い、その間は追跡の番号を頼りに前回の判定を引き継ぐことで、処理の遅れを抑えました。
結果と考察
検出・追跡・識別のいずれも、1フレームごとの識別では正解率は8〜9割に留まりましたが、過去15回分の多数決をとると誤りはなくなりました。字幕システムへの座標のリアルタイム送信にも成功しました。一方で、次のような課題も明らかになりました(表2)。
表2明らかになった課題
| 課題 | 内容 |
|---|---|
| 照明 | 学習時に使用していない照明条件では誤認識が発生した |
| 距離 | カメラから一定以上離れると誤認識が発生し、さらに離れると人物として検出されなくなった |
| 速度 | 処理速度は4〜6fpsにとどまり、役者の動きに対して字幕の追従が遅れた |
| 通信 | 無線環境が不安定で、カメラ映像の受信と座標の送信がたびたび途切れた |
| 座標の基準 | 人物を囲む枠を基準に位置を算出していたため、腕を伸ばすだけで座標が移動した |
照明の問題は、色のついた照明が肌や服の色そのものを変えてしまって、似た特徴量を抽出できなかったことが原因だと考えられます。同定において「色」が重要な要素である可能性が高く、学習データを撮る段階で本番の条件の照明をすべて含めることが必要だと分かりました。
また、役者が一定以上の距離に離れると、そもそも検出すらできなくなりました。最遠距離でも検出できる解像度のカメラを用いることが必要です。
処理速度は、カメラの解像度、人物検出の入力サイズ、特徴抽出の頻度に起因します。
今回はGPUを使わずノートPCのCPUだけで処理したため、特に特徴抽出の計算コストが高くなりました。
解像度や特徴抽出の頻度を下げれば速くなりますが、そのぶん識別精度は下がります。
精度と速度の釣り合いをどこでとるかが、実用化に向けた中心的な課題です。
さらに、役者の動きの速度が上がると追従に遅れが生じるようになりました。
カルマンフィルタなどを用いて予測を入れながら位置推定をすることで、役者の動きに自然に追従した座標取得が実現できるのではと考えています。
通信の途切れは、有線LANで接続することで改善できました。
座標の基準については、人物を囲む枠ではなく、骨格の推定(MediaPipe など)で頭や足元の位置を直接求めれば、腕の動きに左右されずに所望の位置が得られることが期待されます。
今後の展望
スマートフォンのカメラとオープンソースのモデルだけで、予想以上の精度で検出・追跡・識別ができました。
精度と速度がさらに向上すれば、低コストでのリアルタイムトラッキングが小規模な劇場でも現実的になり、役者の動きに応じて音響・照明・映像が反応するインタラクティブな演出の幅が広がると期待できます。
今後は、以下のような点に取り組みます。
- 精度と速度の両立:モデルや処理の間引き方を調整し、識別精度を保ったままフレームレートを上げます。
カルマンフィルターなどを導入して、役者の動きへの追従を滑らかにします。精度と速度の両立:モデルや処理の間引き方を調整し、識別精度を保ったままフレームレートを上げます。カルマンフィルターなどを導入して、役者の動きへの追従を滑らかにします。 - 安定した接続:有線LANでカメラ入力と座標送信を行います。安定した接続:有線LANでカメラ入力と座標送信を行います。
- 位置の基準の改善:骨格推定を用いて、頭上・足元など用途に合った位置を出力します。位置の基準の改善:骨格推定を用いて、頭上・足元など用途に合った位置を出力します。
- 3次元化:今回はほぼ正面から撮影したため実質的に左右方向の位置しか得られませんでしたが、複数のカメラによる三角測量で3次元の位置を得られれば、立体音響や照明との連携が見えてくると考えています。3次元化:今回はほぼ正面から撮影したため実質的に左右方向の位置しか得られませんでしたが、複数のカメラによる三角測量で3次元の位置を得られれば、立体音響や照明との連携が見えてくると考えています。
参考
- [1]Qorvo. Real-Time Tracking, Real-World Impact: Elevating Global Stages with UWB Technology. https://www.qorvo.com/about/news-events/blogs/real-time-tracking-real-world-impact-elevating-global-stages-with-uwb-technology
- [2]Jocher, G., & Qiu, J. (2024). Ultralytics YOLO11. https://github.com/ultralytics/ultralytics
- [3]Aharon, N., Orfaig, R., & Bobrovsky, B.-Z. (2022). BoT-SORT: Robust Associations Multi-Pedestrian Tracking. arXiv:2206.14651. https://arxiv.org/abs/2206.14651
- [4]Zhou, K., Yang, Y., Cavallaro, A., & Xiang, T. (2019). Omni-Scale Feature Learning for Person Re-Identification. Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), 3702–3712. https://arxiv.org/abs/1905.00953